
Architecture technique
Architecture technique
Dodock est un framework applicatif complet, piloté par les métadonnées. Il gère la base de données, le cache, les tâches de fond et les notifications en temps réel des applications métier.
Vue d'ensemble
L'architecture de Dodock s'organise autour du concept de bench : un environnement qui héberge plusieurs sites (tenants) partageant les mêmes applications.
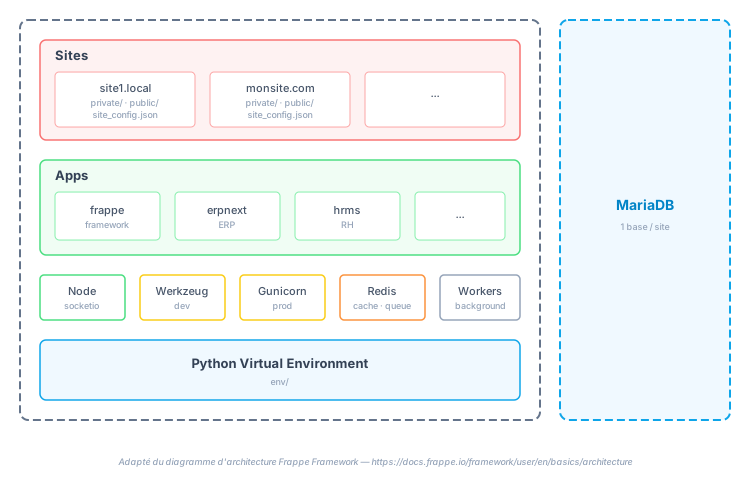
Concepts clés
| Concept | Description |
|---|---|
| Bench | Environnement complet contenant applications, sites et processus |
| Application | Package Python qui étend le framework (dodock, dokos, etc.) |
| Site | Tenant avec sa propre base de données et configuration |
| DocType | Définition d'un type de document (schéma + comportements) |
| Document | Instance d'un DocType (enregistrement en base) |
Architecture multi-tenant
Dodock est une plateforme multi-tenant. Chaque tenant (appelé "site") possède :
- Sa propre base de données
- Ses propres fichiers uploadés
- Sa propre configuration
Les applications sont partagées entre tous les sites du bench.
Pile technique
Composants principaux
| Composant | Technologie | Rôle |
|---|---|---|
| Base de données | MariaDB (PostgreSQL et SQLite existent aussi) | Stockage des données. La clé db_type du site choisit le moteur |
| Cache | Redis | Cache, files d'attente, pub/sub |
| Backend | Python (Werkzeug, Gunicorn) | Logique métier et API REST |
| Temps réel | Node.js (Socket.IO, socketio.js) | Notifications en direct |
| Frontend | JavaScript (Vue.js) | Interface utilisateur |
| Reverse Proxy | Nginx | Routage et SSL (production) |
MariaDB
MariaDB stocke toutes les données : documents, métadonnées des DocTypes, utilisateurs et configurations. Chaque site possède sa propre base de données : sur un bench qui héberge plusieurs sites, les données de chaque site restent séparées.
En production, utilisez MariaDB : c'est le moteur recommandé en v5. SQLite sert seulement aux tests et au développement.
Redis
Deux instances Redis assurent des fonctions distinctes :
| Instance | Rôle |
|---|---|
| redis_cache | Cache en mémoire pour accélérer les lectures |
| redis_queue | Files d'attente des tâches de fond (RQ) et messages du temps réel |
L'ancienne instance redis_socketio n'existe plus : le serveur temps réel utilise redis_queue.
Structure des répertoires
L'initialisation d'un bench avec bench init crée cette structure :
dokos-bench/
├── apps/                         # Applications installées
│   ├── frappe/                   # Framework (obligatoire)
│   ├── erpnext/                  # Application métier
│   └── custom_app/               # Applications personnalisées
│
├── sites/                        # Sites hébergés
│   ├── assets/                   # Assets compilés (JS, CSS)
│   ├── apps.txt                  # Apps installables
│   ├── common_site_config.json   # Configuration partagée
│   └── monsite.localhost/        # Répertoire du site
│       ├── site_config.json      # Configuration du site
│       ├── private/              # Fichiers privés
│       ├── public/               # Fichiers publics
│       └── locks/                # Verrous de synchronisation
│
├── config/                       # Configuration Redis
│   ├── redis_cache.conf
│   └── redis_queue.conf
│
├── logs/                         # Journaux des processus
├── env/                          # Environnement virtuel Python
└── Procfile                      # Définition des processus
Processus et services
L'exécution de Dodock nécessite des services système (base de données, cache) et des processus applicatifs (serveur web, workers).
Les services système dépendent de l'architecture de déploiement. Les processus applicatifs sont définis dans le Procfile en développement et dans config/supervisor.conf en production.
Services système
| Service | Rôle |
|---|---|
| MariaDB | Base de données relationnelle |
| Redis | Cache et files d'attente pour les workers |
| Nginx | Reverse proxy (production uniquement) |
| Supervisor | Gestion des processus (production uniquement) |
Processus applicatifs
Serveur WSGI : répond aux requêtes HTTP. En développement, bench start lance le serveur Werkzeug. En production, Gunicorn est configuré automatiquement via Supervisor.
Workers : exécutent les tâches de fond (emails, rapports, calculs). Démarrés automatiquement par bench start en développement, configurés dans Supervisor en production.
Scheduler : planifie l'exécution des tâches programmées (horaires, quotidiennes, etc.). Même gestion que les workers.
Développement vs Production
| Aspect | Développement | Production |
|---|---|---|
| Lancement | bench start | Supervisor |
| Configuration | Procfile | config/supervisor.conf |
| Serveur WSGI | Werkzeug (mono-thread) | Gunicorn (multi-workers) |
| Reverse proxy | Non | Nginx |
developer_mode
developer_mode est un paramètre distinct du mode de déploiement. Lorsqu'il est activé, les modifications apportées aux DocTypes, rapports et autres composants via l'interface sont répercutées dans le dépôt de l'application.
Cette option s'active dans le fichier site_config.json du site :
sites/{votre_site}/site_config.json
{
  "developer_mode": 1
}
Activé : les modifications apportées aux DocTypes, rapports, scripts et autres composants sont sauvegardées dans le code source de l'application. Elles peuvent être versionnées avec Git, partagées et déployées sur d'autres instances.
Désactivé : les modifications restent dans la base du site. Elles ne sont pas écrites dans le dépôt de l'application.
Activez developer_mode seulement sur un site de développement. La commande bench set-config -g developer_mode 1 l'active pour tous les sites du bench.
Résolution du site
Pour une requête web, le framework choisit le site dans cet ordre :
- Le site imposé au serveur de développement (
bench serve --site) - L'en-tête HTTP
X-Frappe-Site-Name - Le nom d'hôte de la requête (en-tête
Host)
Pour une commande bench, le site vient de l'option --site, de la variable d'environnement FRAPPE_SITE ou du site par défaut (bench use <site>). Le fichier currentsite.txt n'est plus pris en charge.
Configuration
Chaque site possède un fichier site_config.json :
{
  "db_name": "site1_db",
  "db_password": "••••••••",
  "encryption_key": "••••••••"
}
La configuration commune se trouve dans common_site_config.json.
Cycle de vie d'une requête
- Réception : Nginx reçoit la requête HTTP ou WebSocket
- Routage : Nginx route vers Gunicorn (HTTP) ou Socket.IO (WebSocket)
- Résolution : Le framework identifie le site (voir plus haut)
- Authentification : Vérification de la session utilisateur
- Cache : Consultation du cache Redis
- Base de données : Requête MariaDB si nécessaire
- Logique métier : Exécution des contrôleurs et hooks
- Réponse : Sérialisation JSON/HTML et envoi